
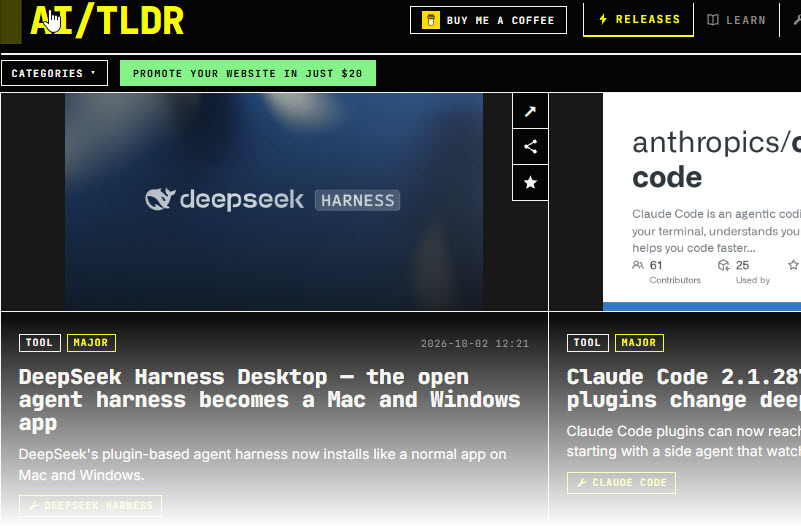
AI/TLDR — сайт, який кожні дві години збирає нові AI-моделі, інструменти, GitHub-репозиторії та дослідження, а потім пояснює їх простою мовою. Без великої редакції, платної підписки й успішного запуску на Product Hunt.
У вересні авторка проєкту писала про приблизно 1 000 унікальних відвідувачів на день. Пізніше на сторінці AI/TLDR у LinkedIn з’явилася цифра у 2 000 щоденних читачів. Якщо дивитися лише на результат, може здатися, що це ще один вірусний AI-медіапроєкт.
Але запуск на Product Hunt приніс йому лише три голоси, одне обговорення і 148-ме місце за день. Сильного акаунта в X у засновників також немає. Найімовірніше пояснення росту набагато прозаїчніше: AI/TLDR перетворив новини на фабрику пошукових сторінок.
Що це
AI/TLDR — одночасно новинна стрічка, каталог AI-інструментів, реєстр моделей і навчальна енциклопедія.
Кожен новий реліз отримує коротке пояснення:
- що саме випустили;
- як це працює;
- чому це важливо;
- кому може знадобитися;
- де знайти першоджерело.
Окремо сайт збирає постійні сторінки моделей із цінами, бенчмарками, контекстним вікном і ліцензією, сторінки open-source інструментів із кількістю GitHub-зірок та інструкціями із запуску, а також статті про RAG, агентів, токени, fine-tuning і роботу з LLM API.
На момент написання статті AI Release Index показує 1 774 відстежені релізи, 1 562 open-source інструменти, 680 джерел і 652 навчальні матеріали. Окремий реєстр містить 373 AI-моделі.
Це вже не блог у звичному розумінні. Це база даних, кожен запис у якій можна перетворити на окрему сторінку для Google.
Звідки взялися 30К
У відкритому доступі немає Google Analytics або іншого незалежного підтвердження саме 30 тисяч унікальних користувачів на місяць.
У пості на Indie Hackers від 9 вересня авторка називає інші цифри: проєкту п’ять місяців, сайт отримує близько 1 000 унікальних відвідувачів на день і має трохи більше 100 підписників на розсилку. Тому 30К, найімовірніше, означає місячні відвідування або суму щоденного трафіку, а не 30 тисяч зареєстрованих людей.
Але цікавіше інше: цей результат майже точно не прийшов з одного успішного запуску.
На Product Hunt AI/TLDR отримав три голоси й навіть не потрапив у featured. Профілі засновників у соціальних мережах теж не мають аудиторії, здатної одразу привести десятки тисяч людей.
Основним каналом виглядає пошук.
Механізм, який тут головний: новина → сутність → SEO-сторінки
AI/TLDR не просто генерує новинні замітки. Він розкладає кожну новину на сутності й додає їх до спільної бази.
Умовно, вихід нової моделі може створити або оновити одразу кілька сторінок:
- Новину про реліз. Короткий матеріал про те, що вийшло і що змінилося.
- Постійну картку моделі. Ціна, ліцензія, параметри, контекстне вікно, бенчмарки й способи доступу.
- Сторінку компанії-розробника. Усі моделі й релізи Anthropic, OpenAI, Google або іншої лабораторії збираються разом.
- Категорійну сторінку. Наприклад, нові AI-моделі, coding tools, security-релізи або open-source репозиторії.
- Запис у статистиці.Кількість релізів, швидкість випуску нових продуктів і позиція компанії серед конкурентів оновлюються автоматично.
- Випуск розсилки.Той самий контент повторно використовується у щоденному дайджесті.
Одна знайдена новина перетворюється не на один текст, а на кілька пошукових точок входу.
Сам сайт пише, що автоматичний агент перевіряє джерела кожні дві години. Матеріал потрапляє в базу, лише якщо система знаходить підтвердження в офіційному блозі, GitHub-релізі, документації або на сторінці дослідження.
За словами одного з авторів проєкту, найскладнішою частиною став не збір новин, а дедуплікація: той самий реліз можуть кілька разів анонсувати в блозі, GitHub, документації та соціальних мережах. Якщо просто зібрати все, стрічка швидко перетвориться на сміття.
Тобто LLM тут не сам продукт. Він працює всередині конвеєра, який знаходить, об’єднує, перевіряє, класифікує й публікує інформацію.
Чому це працює
Головна перевага AI/TLDR — швидкість на запитах, де конкуренція ще не встигла з’явитися.
Коли виходить нова модель, люди одразу починають шукати:
- назву моделі;
- її ціну;
- розмір контексту;
- результати бенчмарків;
- порівняння з попередньою версією;
- спосіб запустити її локально.
У перші години великих оглядів і документації для початківців ще немає. AI/TLDR може опублікувати структуровану сторінку раніше за традиційні медіа й зайняти пошукову видачу, поки запит тільки формується.
Новинний трафік швидко зникає, тому поруч існує другий шар — 652 навчальні статті. Це матеріали на кшталт «Що таке пам’ять AI-агента», «Як працює semantic chunking» або «Що означають параметри моделі».
Більшість із них побудована за одним шаблоном:
- пояснення простою мовою;
- аналогія;
- навіщо це потрібно;
- як працює;
- типові помилки;
- FAQ;
- внутрішні посилання на сусідні теми.
Схоже, що значна частина енциклопедії створена за допомогою LLM: сотні сторінок мають однакову структуру й близькі дати публікації. Але це не випадкові статті на випадкові ключові слова. Вони утворюють карту однієї теми й підтримують одна одну внутрішніми посиланнями.
Новини дають сайту швидкість. Енциклопедія — довгий пошуковий хвіст. Реєстри моделей та інструментів — запити з практичним і комерційним наміром.
Окремий трюк: сайт сам просить себе цитувати
На сторінці зі статистикою біля окремих показників є готовий блок Cite this.
Наприклад, сайт пропонує авторам інших матеріалів готове формулювання про те, яка лабораторія випускає найбільше релізів або який open-source інструмент має найбільше GitHub-зірок.
Це маленька, але розумна деталь. Якщо журналіст, автор розсилки або LinkedIn-поста шукає цифру для свого матеріалу, AI/TLDR одразу дає йому готову цитату й посилання.
Так з’являється наступний цикл:
статистика → зовнішні згадки → сильніший домен → кращі позиції нових сторінок → більше людей і нових згадок
Паралельно контент розноситься через щоденну розсилку Buttondown, Medium, DEV, LinkedIn та Indie Hackers. Ці канали навряд чи самі створили весь трафік, але допомогли Google знайти сайт і дали перші зовнішні посилання.
Як це можна повторити
Найпростіший висновок із цього кейсу — «згенерувати кілька сотень статей». Але без решти системи це навряд чи дасть такий самий результат.
Механізм AI/TLDR можна розкласти так:
- Знайти нішу, де постійно з’являються нові сутності. Це можуть бути продукти, гранти, вакансії, закони, тарифи, API, тендери, нерухомість або зміни в документації.
- Збирати дані з першоджерел. Не переписувати інші агрегатори, а відстежувати офіційні сторінки, репозиторії та changelog.
- Нормалізувати інформацію. Одна компанія, продукт або реліз мають існувати в базі один раз, навіть якщо про них написали п’ять джерел.
- Створити кілька типів сторінок. Новина відповідає на запит «що сталося», картка сутності — «що це», каталог — «які є варіанти», а навчальна стаття — «як це працює».
- Зв’язати все внутрішніми посиланнями. Кожна нова сторінка має посилювати старі, а старі — допомагати Google знаходити нові.
- Додати причину повернутися. Стрічка, сповіщення, розсилка або персональний список спостереження перетворюють одноразовий SEO-візит на звичку.
AI прискорює написання, але основною роботою залишається дизайн бази: які сутності існують, як вони пов’язані й які сторінки з них можна зібрати.
Де це крихко
Перш ніж сприймати AI/TLDR як готовий рецепт, варто врахувати кілька обмежень.
По-перше, цифри трафіку походять від самих авторів. Відкритої аналітики, яка підтверджує 30К унікальних користувачів, немає. А 1 000 щоденних відвідувачів не обов’язково означає 30 тисяч різних людей на місяць: частина аудиторії повертається щодня.
По-друге, станом на вересень проєкт показував $0 доходу і трохи більше 100 підписників. Це означає, що велика кількість відвідувань поки слабо перетворюється на власну аудиторію або гроші.
По-третє, сайт залежить від Google. Якщо пошуковик вирішить, що сотні схожих LLM-статей недостатньо корисні, значна частина трафіку може зникнути так само швидко, як з’явилася.
По-четверте, швидкість створює ризик помилок. Ціни, бенчмарки, кількість зірок і характеристики моделей постійно змінюються. Автоматична перевірка URL не гарантує, що система правильно зрозуміла джерело.
Нарешті, масове генерування працює лише тоді, коли за ним є дані. Без реєстру моделей, зв’язків між релізами, системи дедуплікації й постійного оновлення це був би просто ще один AI-блог.
Висновок
Найцінніший урок AI/TLDR — не «Google любить AI-статті».
Проєкт знайшов ринок, де інформація змінюється щодня, а люди хочуть отримувати її швидше, ніж великі медіа встигають писати огляди. Потім кожну новину перетворив на структуровані дані, а дані — на десятки типів пошукових сторінок.
Схема виглядає так:
першоджерела → дедуплікація → база сутностей → SEO-сторінки → пошуковий трафік → повернення в щоденну стрічку
Тексти тут справді значною мірою автоматизовані. Але самі по собі вони не пояснюють результат. Фішка — у конвеєрі, який публікує потрібну сторінку в той момент, коли люди тільки починають її шукати.
